Application data & IA · 2026
Courant
Le command center temps réel de l'électricité française, avec un analyste IA qui montre ses requêtes.
- mesures RTE en base (2012-2026)
- 514 020
- fréquence d'ingestion n8n
- 1 h
- d'historique pour les repères
- 14 ans
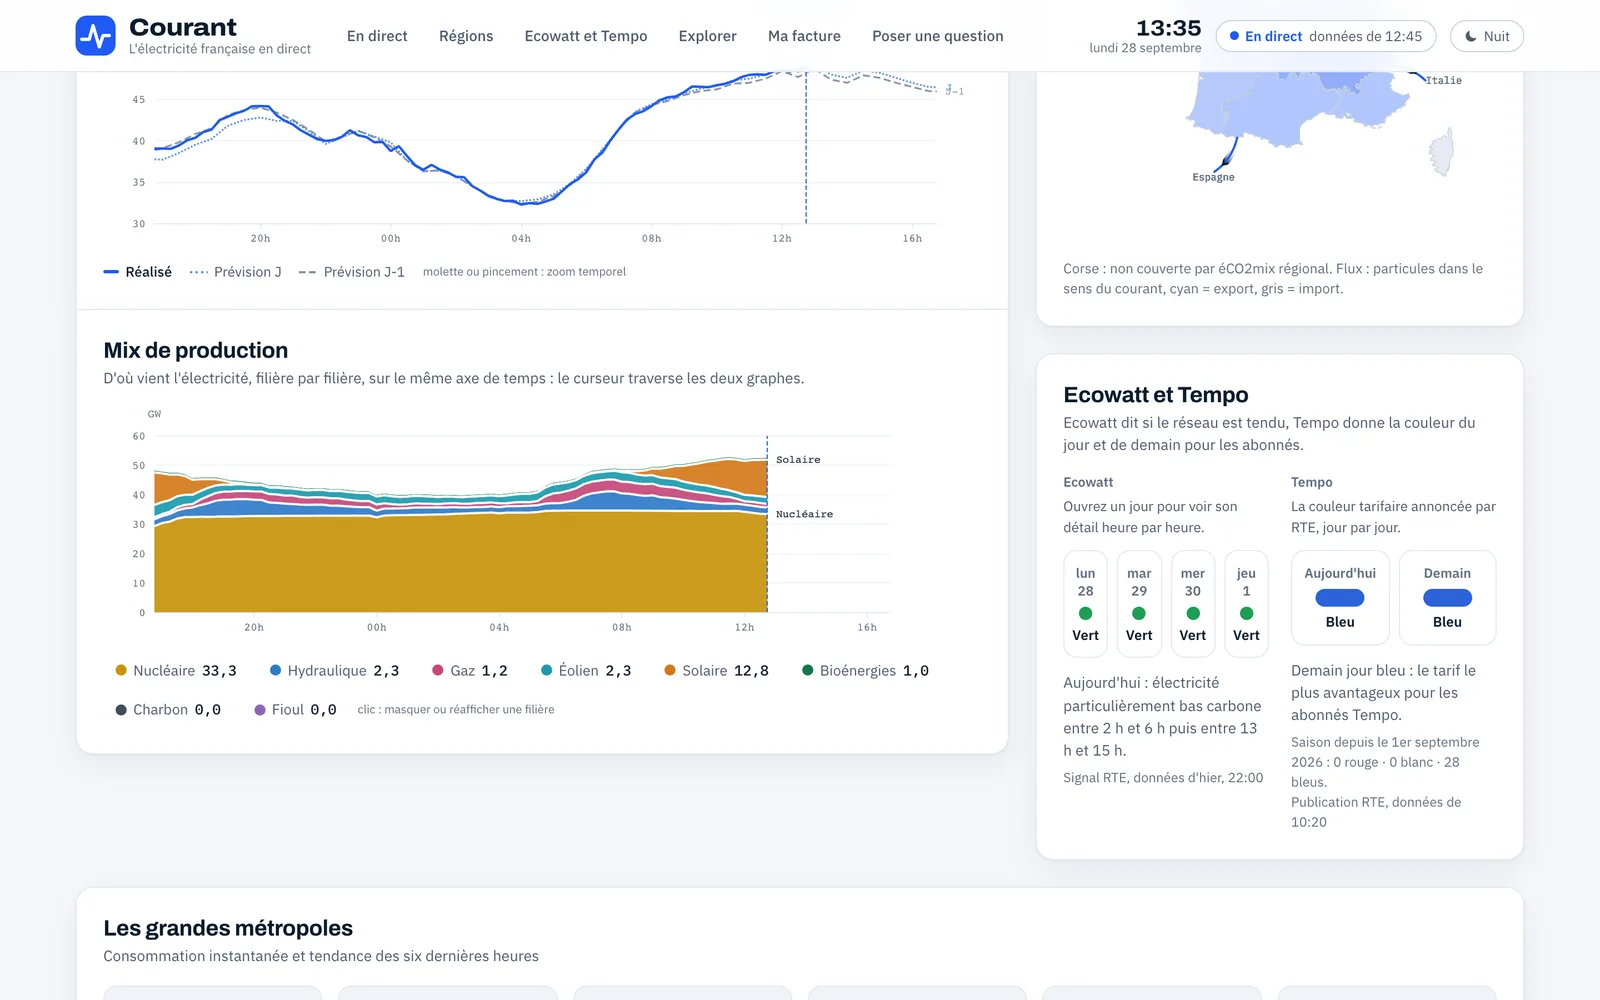
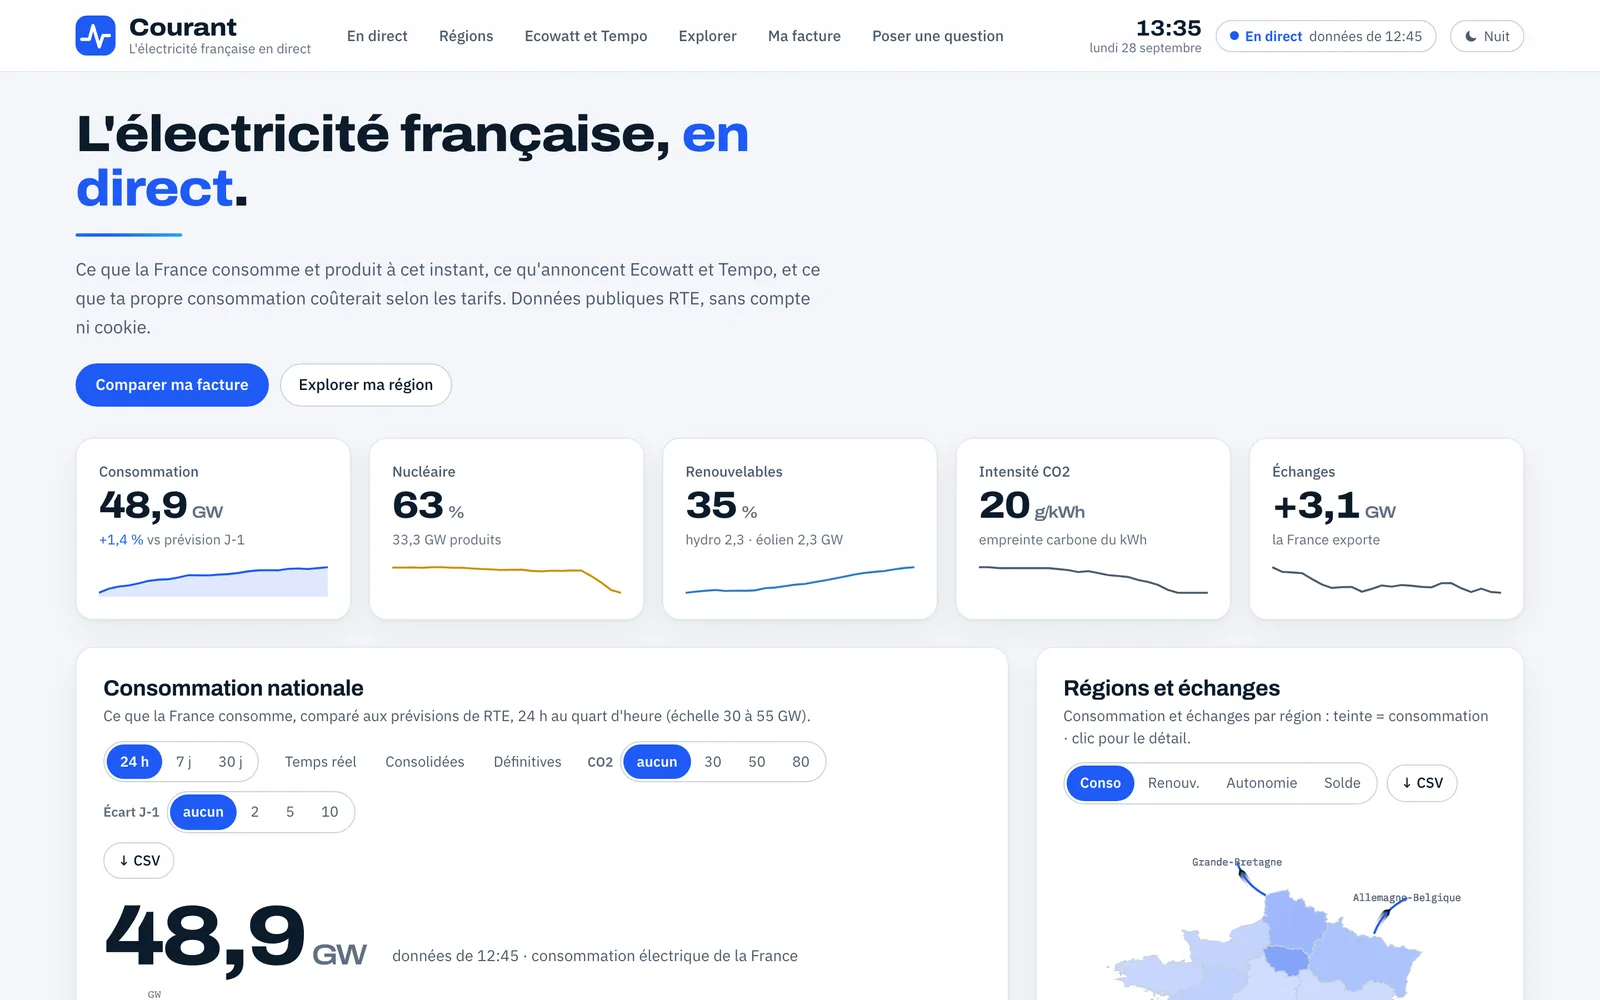
Consommation, production par filière, échanges, Ecowatt et Tempo en direct, un brief quotidien rédigé par IA et un chat en langage naturel adossé à du SQL validé.
Contexte
Les données du système électrique français sont publiques (RTE, via la plateforme ODRÉ), mais éparpillées et peu lisibles pour le grand public. Que consomme la France maintenant ? Importe-t-on ou exporte-t-on ? Demain, jour rouge ou jour bleu ?
Le problème à résoudre
Rendre ces données lisibles en quelques secondes, en temps réel, et permettre à chacun de poser ses propres questions sans jamais laisser une IA inventer un chiffre.
Ma démarche
- Pipeline : ingestion horaire orchestrée par n8n depuis les API RTE, stockage dans Supabase en deux couches (ingestion puis marts), records historiques précalculés.
- Visualisation : tableaux de bord nationaux et régionaux, carte des échanges, mix de production, signaux Ecowatt et couleurs Tempo, comparateur de facture.
- IA encadrée : un brief quotidien rédigé à partir des chiffres de la veille (le modèle rédige, il ne calcule pas) et un chat « Pose ta question » dont les requêtes SQL sont générées, validées côté serveur, puis affichées à l’utilisateur.
- Qualité : TypeScript strict, TDD, tests end-to-end Playwright, décisions d’architecture documentées (ADR), CI GitHub.
Résultat
Une application publique alimentée en continu, avec 514 020 mesures couvrant 2012 à 2026, des repères statistiques sur 14 ans et un affichage explicite quand une source est indisponible : aucune donnée simulée.
Ce que ce projet montre
Un pipeline data industrialisé de bout en bout et un usage responsable de l’IA générative : transparence des requêtes, garde-fous côté serveur, séparation stricte entre calcul et rédaction.